最終更新: 2026-10-18
100万ページを取得したところ、圧縮HTMLならプロキシ通信量は43GBで済みましたが、同じページをフルブラウザで読み込むと1.4TBになりました。2026年10月時点のローテーションレジデンシャルプロキシ料金に換算すると、前者は43ドルから171ドル、後者は701ドルから4,991ドルで、プロバイダーによって差があります。
テキストデータセットの元になっている10個のソースから60ページを、ローテーションレジデンシャルプロキシ経由で4通りの方法で読み込み、各方法で発生する通信量と、返ってくるクリーンなテキスト量を測定しました。結果は1ページあたり約5KBでした。10ソース中9ソースはデータセンターのサーバーから直接アクセスしても応答したため、まず「そもそもプロキシが必要か」が最初の論点になります。
結論だけ知りたい人向け
- まずはプロキシなしで始める。 Common Crawl、Wikipediaのダンプ、公式APIでオープンウェブの多くをカバーでき、私たちが試した10ソース中9ソースはプロキシなしでもデータセンターIPに対して配信しました。
- ページではなくHTMLを取得する。 中央値で、圧縮HTMLは43KB、フルブラウザでは591KBで、同じテキストでも通信量は14倍でした。
- 圧縮を有効にする。 これがないと、同じHTMLでも43KBではなく200KBになりました。
- 開放的なサイトはデータセンタープロキシ、IPを判定するサイトはローテーションレジデンシャルプロキシ。 Redditでは、7社のレジデンシャル出口は試行の75から100%で通りましたが、2社のデータセンター出口は0%と62.5%でした。
- 自分のボリュームで価格を比較する。 私たちが測定しているローテーションレジデンシャルプロキシ提供7社はいずれもリクエストの98から100%を配信しましたが、1TBプランのGB単価は最大7倍の開きがあります。
- プロキシが変えるのはIPであって、サイト側のルールではない。 robots.txtを公開している上位サイトの23%は、少なくとも1つのAIクローラを名前指定でサイト全体から締め出しています。
そもそもプロキシは必要か
公開データセットに含まれるテキストの多くは、そもそも配布されることを前提に提供されています。Common Crawlは数十億ページ規模のクロールを定期的に無料で公開し、Wikimediaは各Wikipediaの完全なデータベースダンプを提供し、arXivにはAPIがあります。このテストで使ったarXiv論文リストも、そのAPIから取得しました。ソースにダンプやAPIがあるなら、どんなクロールよりも安く、しかも網羅的です。
実際にクロールする場合でも、最初の壁がIPであることはまれです。ロンドンのデータセンターにある私たちのサーバーから、プロキシなしで60ページをそれぞれ1回ずつリクエストしました。Wikipedia、Hacker News、arXiv、BBC、The Guardian、GOV.UK、MDN、GitHub、DEVは200で応答しました。Stack ExchangeはCloudflareのチャレンジ付きで403を返し、レジデンシャルプロキシ4本(Evomi、NodeMaven、Proxy Seller、Proxies.Vision)を使ったcurlでも、Evomi経由のヘッドレスChromiumでも同じ応答でした。このチェックはIPというよりクライアント側を見ており、IPを変えても結果は変わりません。
ページあたり1リクエストではクロールとは呼べません。プロキシが料金分の価値を持つのは主に3つのケースです。サイトがIPごとにリクエスト数を制限していて量が必要な場合、サイトがIPの評判で判断する場合(Redditは私たちのサーバーに403「blocked by network security」を返しました)、または国によって内容が変わる場合です。
1ページあたりの通信量コスト
各ページは同じローテーションレジデンシャルプロキシを通し、4通りで取得しました。圧縮なしのcurl、圧縮ありのcurl、画像とフォントとメディアをブロックしたヘッドレスChromium、そしてChromiumでのフル読み込みです。最後の列は、trafilaturaがHTMLから抽出したクリーンテキストで、コメントと表も含みます。ソースごとに6ページの中央値で、単位はKBです。
| ソース | HTML、圧縮 | HTML、非圧縮 | ブラウザ、画像、フォント、メディアなし | ブラウザ、フルページ | クリーンテキスト |
|---|---|---|---|---|---|
| arXiv | 44 | 44 | 285 | 548 | 3 |
| BBC | 54 | 288 | 3,016 | 3,811 | 4 |
| DEV | 51 | 295 | 1,382 | 1,801 | 17 |
| GitHub | 70 | 441 | 2,093 | 2,386 | 16 |
| GOV.UK | 17 | 87 | 112 | 191 | 3 |
| Hacker News | 7 | 38 | 11 | 12 | 7 |
| MDN | 25 | 188 | 198 | 569 | 6 |
| The Guardian | 62 | 343 | 639 | 1,079 | 7 |
| Wikipedia | 40 | 187 | 346 | 469 | 7 |
| 54ページ全体 | 43 | 200 | 358 | 591 | 5 |
圧縮は最も手軽で効果の大きい節約策です。curlは--compressedを付けない限りAccept-Encodingを送らないため、付けない場合は中央値で43KBではなく200KBになりました。Python requestsはデフォルトでgzipを要求します。arXivだけは、どちらでも同じ非圧縮HTMLを返した唯一のソースでした。
ブラウザは、ページが読み込むものすべてに対して通信量が発生します。スクリプト、スタイル、画像、広告、解析です。BBCの記事ページは中央値で176リクエストで、テキストは4KBしかないのに通信量は3.8MBでした。画像とフォントとメディアをブロックすると、全ページ合計でブラウザの通信量が38%減りましたが、それでも圧縮HTMLの21倍です。54ページすべてで、テキストはすでにcurlが受け取るHTML内に入っていたため、テキストデータセットという目的ではブラウザを使う価値はありませんでした。
全ページを通して、クリーンテキスト1KBあたりのコストは、圧縮HTMLで4.7KB、フルブラウザ通信で156KBでした。この構成で100万ページなら、4通りそれぞれで43GB、241GB、889GB、1,430GBになります。
100万ページのコスト
同じ100万ページを、2026年10月時点の当社カタログ価格で、そのボリュームに該当するプラン単価を用いて計算しました。圧縮HTMLは40から60GBプラン、フルブラウザ読み込みは1TBプランです。プロバイダーはアルファベット順で、いずれも私たちが毎週プロキシを測定している対象です。
| プロバイダー | 種類 | GB単価、40から60GBプラン | 総額、43GB | GB単価、1TBプラン | 総額、1.4TB |
|---|---|---|---|---|---|
| Evomi | ローテーションレジデンシャルプロキシ | $0.99 | $43 | $0.49 | $701 |
| NodeMaven | ローテーションレジデンシャルプロキシ | $3.98 | $171 | $2.75 | $3,932 |
| Proxies.Vision | ローテーションレジデンシャルプロキシ | $1.00 | $43 | $1.00 | $1,430 |
| Proxmint | ローテーションレジデンシャルプロキシ | $1.53 | $66 | $1.25 | $1,788 |
| Proxy Seller | ローテーションレジデンシャルプロキシ | $2.30 | $99 | $1.45 | $2,074 |
| Thordata | ローテーションレジデンシャルプロキシ | $1.50 | $64 | $0.73 | $1,044 |
| ThunderProxy | ローテーションレジデンシャルプロキシ | $3.69 | $159 | $3.49 | $4,991 |
| Evomi | ローテーションデータセンタープロキシ | $0.45 | $19 | $0.30 | $429 |
| SpaceProxy | ローテーションデータセンタープロキシ | $0.99 | $43 | $0.99 | $1,416 |
請求額への影響は、プロバイダーよりも取得方法のほうが大きいです。ローテーションレジデンシャルプロキシでは、最も安いフルブラウザクロールでも、最も高い圧縮HTMLクロールの4倍のコストになります。プロバイダー間の差は配信品質ではなく価格にあります。最新の週次実行の当社ベンチマークでは、ローテーションレジデンシャルプロキシ提供7社すべてが200リクエストの98から100%を配信しました。1TBプランでのGB単価は0.49ドルから3.49ドルまで幅があります。
ソースごとにどのプロキシタイプを使うべきか
当社ベンチマークでは毎週、各プロキシに200リクエストを送り、さらにIPの評判で判定する2サイトであるRedditとZillowへ、それぞれ8リクエストずつ送ります。私たちが測定している全プロバイダーについての最新結果は2026年10月時点で次のとおりです。
| 種類 | 測定プロバイダー数 | 配信されたリクエスト | Redditで通過 | Zillowで通過 | GB単価、1TBプラン、カタログ中央値 |
|---|---|---|---|---|---|
| ローテーションレジデンシャルプロキシ | 7 | 98から100% | 75から100% | 75から100% | 71社の中央値で$1.70 |
| ローテーションデータセンタープロキシ | 2 | 98.5%と100% | 0%と62.5% | 62.5%と100% | 24社の中央値で$0.62 |
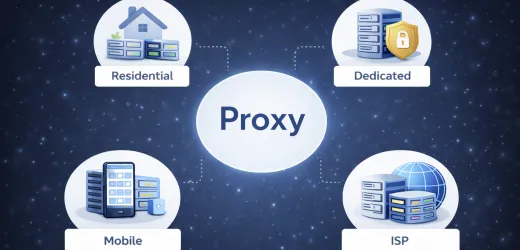
| ローテーションモバイルプロキシ | 2 | 98.5%と100% | 87.5%と100% | 62.5%と100% | 31社の中央値で$3.00 |
データセンターは開放的なソースには十分です。Wikipedia、arXiv、GOV.UK、ニュースサイト、ドキュメント、GitHubはいずれも私たちのデータセンターサーバーに配信したため、データセンタープールは主にリクエストを分散させるためのIP追加という役割になり、価格はレジデンシャルのおよそ3分の1です。
ローテーションレジデンシャルプロキシはIPで判定するサイト向けです。Redditではレジデンシャル出口が75から100%通過した一方、データセンタープール2つは0%と62.5%でした。
モバイルはレジデンシャル中央値のほぼ2倍のコストで、私たちの実行では通過率も上がらなかったため、テキスト収集の目的では支払う理由が見当たりません。
コーパスをクロールする場合、リクエストごとにIPを変えるのが標準です。スティッキーセッションのように数分間同じIPを使うのは、ページネーションやログインがIPに紐付く場合にだけ意味があります。
robots.txtがAIクローラにすでに伝えていること
Trancoリスト上位1,000ドメインのrobots.txtを読みました。526件がrobots.txtを公開しており、そのうち123件は、少なくとも1つのAIクローラを名前指定でサイト全体から締め出しています。Common CrawlのクローラであるCCBotが87件、GPTBotが85件、ClaudeBotが84件、Google-Extendedが70件です。すべてのボットをサイト全体から締め出している44件は数に入れていません。多くは技術系ドメインでした。
これらのルールはAI向けデータ収集を念頭に書かれているため、同じ目的で動かすクローラにも、どのIPから来たかに関係なく適用されます。プロキシが変えるのはリクエストの発信元であって、サイトが同意したかどうかではありません。クローラには独自のユーザーエージェントを与え、RFC 9309が定めるとおりrobots.txtに従い、テキストをデータセットに入れる前にサイトの利用規約とライセンスも確認してください。
通信量を節約する構成
ローテーションプロキシ付きのPython requests。プロキシアドレスは両方のキーでhttp://から始めます。https://のプロキシアドレスは別の意味になるため、SOCKS5とHTTPSプロキシを参照してください。
import requests

proxy = "http://user:pass@gate.example.com:port"
s = requests.Session()
s.proxies = {"http": proxy, "https": proxy}
s.headers["User-Agent"] = "examplebot/1.0 (+https://example.com/bot)"
r = s.get(url, timeout=30) # gzip is requested by defaultcurlではフラグが必要です。curl --compressed -x http://user:pass@host:port URLです。
ブラウザが本当に必要なページでは、テキストに不要なものをブロックします。Playwrightでは次のとおりです。
await page.route("**/*", r =>
  ["image", "media", "font"].includes(r.request().resourceType())
? r.abort() : r.continue())429と503では再試行の前にRetry-Afterを待ち、ドメインごとにリクエストレートを維持してください。ローテーションはIP間にリクエストを分散しますが、サイトがcookieやアカウント、APIキー単位でリクエスト数を数える場合、サイト側からは単一クライアントとして見えたままです。
このテストのプロバイダー
アルファベット順です。Evomiは両方のローテーションタイプを販売しており、SpaceProxyはローテーションデータセンターでテストに参加しています。

 Evomi
https://evomi.com/
$0.49/GB
プロキシタイプ
モバイルプロキシ, レジデンシャルプロキシ, ISP プロキシ, データセンタープロキシ
IPプール
100M+ IP
設立日
2014
本社
スイス
メリットとデメリット
- 無料トライアル
- 30日以内の返金
- 大量購入でGB単価が最大51%安い
- 1つのアカウントで5種類のプロキシ
- 月額料金なしで利用できる従量制プラン
- カード払いの場合、別途VATが課されます
 NodeMaven
https://nodemaven.com/
$2.75/GB
プロキシタイプ
モバイルプロキシ, レジデンシャルプロキシ, ISP プロキシ
IPプール
30M+ IP
設立日
2023
本社
エストニア
メリットとデメリット
- $3.50の有料テスト
- 大量購入でGB単価が最大48%安い
- 月次プランでは、未使用のトラフィックは翌月に繰り越されます
- 従量課金オプションあり
- 支払い方法が限られている
プロキシタイプ
レジデンシャルプロキシ
IPプール
30M+ IP
設立日
2026
本社
シンガポール
メリットとデメリット
 Proxmint
https://proxmint.com/
$1.25/GB
プロキシタイプ
モバイルプロキシ, レジデンシャルプロキシ, データセンタープロキシ
IPプール
90M+ IP
設立日
2026
本社
インドネシア
メリットとデメリット

プロキシタイプ
モバイルプロキシ, レジデンシャルプロキシ, 専用 IPv6 プロキシ, ISP プロキシ, データセンタープロキシ
IPプール
47M+ IP
設立日
2014
本社
キプロス
メリットとデメリット
- 24時間以内の返金
- 大量購入でGB単価が最大63%安い
- 1つのアカウントで8種類のプロキシ
- SDK:PHP, Python, Node.js, Java, GoLang
- 24時間365日のサポート

 SpaceProxy
https://spaceproxy.net/
$0.99/IP
プロキシタイプ
専用 IPv6 プロキシ, データセンタープロキシ
IPプール
47M+ IP
設立日
2019
本社
キプロス
メリットとデメリット
- 2日以内の返金
- 8種類の支払い方法
- IPv6プロキシあり
- 幅広い国の選択肢
- カスタマーサポートの品質に関する苦情があります。
 Thordata
https://thordata.com/
$0.65/GB
プロキシタイプ
レジデンシャルプロキシ
IPプール
100M+ IP
設立日
2018
本社
香港 (ホンコン)
メリットとデメリット
- 無料トライアル
- 返金可能
- 大量購入でGB単価が最大68%安い
- 最大90分のスティッキーセッション
- ASNターゲティング
- 当社のテストでは初回リクエストが遅い
- トライアルはサポート経由での依頼時のみ
- レジデンシャルプロキシではSOCKS5非対応
プロキシタイプ
レジデンシャルプロキシ, ISP プロキシ, データセンタープロキシ
IPプール
30M+ IP
設立日
2023
本社
リトアニア
メリットとデメリット
テスト方法
通信量テストは2026年10月18日に、ロンドンのデータセンターにある当社サーバーから実施しました。
- ページ数: Wikipedia(ランダム記事)、Hacker News(フロントページのディスカッション)、arXiv(新着cs.CL論文)、BBC News、The Guardian、GOV.UKのガイダンス、MDN、GitHub(トレンドリポジトリ)、DEV、Stack Exchange(Super User)から各6ページで、合計60ページです。
- 各ページはまず直接1回リクエストし、その後Evomiのローテーションレジデンシャルプロキシ経由で、curl 8.5を
--compressedなしとありで各1回、さらにPlaywright経由のChromiumで、画像とフォントとメディアをブロックしたものを1回、フルで1回実行しました。ページのloadイベントまで待機し、その後ネットワークが落ち着くまで最大10秒追加で待ちました。 - ブラウザ通信量は、Chromiumがネットワーク越しに受信したバイト数で、ヘッダーも含みます。
- Stack Exchangeはすべてのリクエストに403で応答したため通信量の集計から外し、集計は54ページを対象にしています。
- テキストは非圧縮HTMLからtrafilatura 2.3で抽出しました。
- 価格は2026年10月時点の当社カタログに基づき、そのボリュームに該当するプラン価格を用いました。
- Reddit、Zillow、配信率は、各プロバイダーに対する当社週次ベンチマークの最新実行結果です。
- robots.txt: Trancoリスト8PX8Vの上位1,000ドメインで、あるクローラに対して閉鎖と見なす条件は、そのグループに
Disallow: /があることです。
これは単発のテストで、週次ベンチマークとは別に実施しました。
出典
- Common Crawl
- Wikimediaデータベースダンプ
- arXiv API
- RFC 9309: Robots Exclusion Protocol
- Trancoリスト 8PX8V
- GitHub上の当社プロキシベンチマークコード
FAQ
- LLMの学習データを集めるのにプロキシは必要ですか?
- 必ずしも必要ではありません。Common CrawlやWikipediaのダンプ、公式APIを使えば、プロキシなしでもオープンウェブの多くを取得できますし、私たちのテストでも10件中9件のソースはデータセンターサーバーへの直接アクセスに応答しました。プロキシが役に立つのは、サイトがIPあたりのリクエスト数を制限している場合、IPの評判で判定している場合、国によって表示内容を変えている場合です。
- AIのデータ収集に最適なプロキシの種類はどれですか?
- Wikipedia、arXiv、ニュース、ドキュメントのようなオープンなサイトにはデータセンタープロキシが適しています。これらは私たちのデータセンターIPでも配信され、データセンターのトラフィックはレジデンシャルのおよそ3分の1のコストだからです。IPを厳しく判定するサイトにはローテーションレジデンシャルプロキシが有効です。Redditでは7社のレジデンシャル出口が試行の75から100%で通った一方、データセンター出口は0%と62.5%でした。
- 100万ページで必要になるプロキシトラフィックはどれくらいですか?
- 9つのソースから54ページを対象にした私たちのテストでは、圧縮HTMLで43GB、非圧縮で241GB、画像、フォント、メディアをブロックしたヘッドレスブラウザで889GB、通常のブラウザでは1,430GBでした。クリーンなテキストは1ページあたり約5KBでした。
- ヘッドレスブラウザでスクレイピングすべきですか?
- テキストがHTML内に含まれていない場合に限ります。私たちが検証した54ページはいずれもHTML内に含まれており、中央値では通常のブラウザ読み込みは圧縮HTMLの14倍のトラフィックを消費しました。ブラウザが必要な場合でも、画像、フォント、メディアをブロックするとトラフィックを38%削減できました。
- プロキシを使えばrobots.txtを無視できますか?
- できません。プロキシが変えるのはリクエストの送信元IPであって、サイトが許可する内容ではありません。robots.txtを置いている上位526サイトのうち123サイトは、少なくとも1つのAIクローラを名指ししてサイト全体を閉じており、そのルールは同じ目的でデータを収集するあらゆるクローラに適用されます。
- LLMデータにはローテーションとスティッキー、どちらのプロキシが適していますか?
- コーパスをクロールするなら、リクエストごとに新しいIPに切り替わるローテーションが適しています。スティッキーセッションが必要なのは、ページネーションやログインを1つのIPにひも付けているサイトだけです。